2026 年 9 月 Hugging Face Papers Top20:Harness、Skill 与模型自我改进
作者:XD / 发表: 2026年10月11日 22:19 / 更新: 2026年10月11日 22:19 / 科研学习 / 阅读量:2
Hugging Face Papers 2026 年 9 月榜单里,Agent 的执行框架(harness)、技能复用和自我改进占了很大篇幅,另外几条值得关注的路线是实时视频、结构化数据、机器人上下文学习和隐空间语言模型。下面按 Hugging Face 2026-09 月榜的点赞数,直接介绍 Top20。
数据快照为 2026 年 10 月 12 日:20 篇共 8194 票,平均 409.7 票;16 篇列出 GitHub,17 篇列出项目入口。按月榜收录选取,包含两篇 8 月首发论文;点赞和 stars 是抓取时页面的累计值,不是 9 月新增量。机构沿用 HF 的 organization,不代表完整作者单位。下文摘要由原始摘要整理,实验数值为作者报告,分析与适用边界另行说明。
Top20
1. Raven: The Harness of Harnesses for Composable Agentic Intelligence
中文摘要:Raven 面向跨领域、长周期任务,不再要求一套通用 harness 包办所有工作,而是自动构建和改进面向特定模型、特定领域的模块化执行框架。每个可执行的“模型 + harness”组合被视为一个可以调用和协作的能力单元,再由 Host Agent 分解目标、匹配子任务、安排依赖并整合产物。
方法与结果:系统把任务编排和经验保存分开处理。Host archive 与 EverOS 保存跨任务经验,Skill Forge 将经验整理成可复用流程,专业 Agent 则负责具体执行。论文给出组合扩大可靠任务覆盖范围的充分条件,前提包括共享资源预算;实验报告在复杂、长周期任务上优于所比较的 Agent 系统,但摘要没有提供统一提升幅度。
怎么看:值得关注的不是简单增加 Agent 数量,而是让不同执行框架成为可组合、可演化的单元。已有多个专业 Agent 的团队可以参考这种编排方式。不过,多 Agent 的收益需要和通信成本、上下文重复、失败恢复一起核算;理论里的充分条件,也不能直接理解为任意组合都能获得提升。
图源:作者 GitHub README,展示研究、设计、开发、巡检与结果整合的依赖关系。
2. Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
中文摘要:Vidu S2 把实时视频生成拆成两类能力:S2-Avatar 面向可交互数字角色,S2-Editing 面向视频流的实时编辑。前者支持 720p 生成,并允许随时更新参考信息;后者可以改变视频风格、衣服、角色和背景。论文还探索两种模型进行实时空间视频生成的可行性。
方法与结果:相比 Vidu S1,重点从连续生成扩展到动态参考更新和更强的指令跟随,例如让角色执行指定动作。Editing 则把修改对象从离线视频变成持续输入的视频流。作者报告其优于所选基线,并提供可交互 Demo;摘要没有给出统一 FPS、端到端延迟或硬件配置,因此不能沿用 S1 的速度指标来描述 S2。
怎么看:这条路线更接近实时创作工具,而不是一次性生成短片。数字角色、直播和交互式剪辑都能从中受益。实际体验仍要检查参考切换时是否跳变、编辑是否影响主体身份,以及长时间运行能否保持一致性。“探索空间视频”也不等于已经完成通用三维世界建模,需要区分演示能力与系统稳定性。
3. HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
中文摘要:HarnessDev 不只测 Agent 能否完成任务,而是测模型能否给自己搭建执行基础设施。Creation 阶段从最小种子框架和少量案例出发,构造完整执行系统;Evolution 阶段利用下游执行反馈,继续修改自己创建的 harness。评测同时看隐藏任务成功率和执行 token 成本。
方法与结果:Creation 实验覆盖六个构建模型、四个领域、五个下游 benchmark,共 2207 个唯一实例,隐藏测试不参与开发。生成框架在代码、搜索和研究上仍落后于成熟人工框架,在写作和机器学习实验上则能达到或超过所选参考。演化阶段有提升,但不稳定,迁移到隐藏任务和不同执行模型时会缩水。
怎么看:它把“模型能写一个 Agent 框架”与“这个框架真的好用”分开了。特别值得看的是构建模型和运行模型的区别:某个模型设计出的提示、工具和控制流程,不一定适合另一个模型执行。对自动优化 harness 的工作,最好同时报告隐藏集、模型迁移和预算,否则很容易只证明框架适应了开发案例。
4. LimiX-2: A Contextual Mechanism Network Towards General Structured-Data Intelligence
中文摘要:LimiX-2 是结构化数据基础模型,采用 Contextual Mechanism Networks(CMNs)和 Context-Conditional Masked Modeling(CCMM)。它不只把表格学习理解成“给定特征预测标签”,而是根据上下文共同建模特征与标签的联合结构,希望从中学到数据生成机制。
方法与结果:预训练使用结构因果模型生成的合成数据,覆盖不同图结构、函数机制和观测过程,再沿既有 scaling laws 扩展模型与数据。作者在 TabArena、TALENT 和 BCCO 上报告优于所比较的专用模型和表格基础模型,并发现特征注意力能够编码直接因果关系,支持因果骨架恢复。
怎么看:它把表格基础模型的目标从预测精度推进到机制表示,适合和传统 PFN 路线对照阅读。落地时仍要核对真实数据缺失、类别编码、上下文规模和推理成本。尤其不能把注意力中出现因果结构,直接等同于真实业务数据上的因果识别:合成数据的生成假设与实际观测条件之间,仍可能存在明显差距。
5. Scaling Automatic Research Agents via World Models
- 点赞:488
- HF 机构:University of Illinois at Urbana-Champaign
- 链接:HF · arXiv · GitHub(35 stars)· 项目页
- 收录说明:8 月首发,进入 9 月月榜。
中文摘要:自动科研 Agent 的 RL 训练有两种成本:模型生成可以批处理,但实验执行需要独占沙箱和真实机器时间。任务越长,执行环境越容易成为瓶颈。World Model RL(WMRL)用学习到的世界模型替代部分环境执行,从而减少真实实验的等待和资源占用。
方法与结果:世界模型给出的奖励可能带有偏差与噪声,因此 WMRL 加入 Online Debiasing 和 Inverse-Variance Denoising,分别处理系统偏差和随机波动。作者提供收敛保证的分析,并报告在不同任务、不同 Agent 规模上获得 3–4 倍训练加速,同时超过标准 RL 基线;4B、9B Agent 在隐藏 benchmark 上也优于所比较的更大开放权重 Agent。
怎么看:这里的 world model 是训练环境代理,不只是视频生成器。它的意义在于把昂贵实验从每次必跑变成更有选择地运行,但前提是代理误差能被持续校正。适合执行成本高、环境反馈可建模的任务;如果模型对新操作或失败状态预测不准,加速可能以优化错误目标为代价,不能只看吞吐收益。
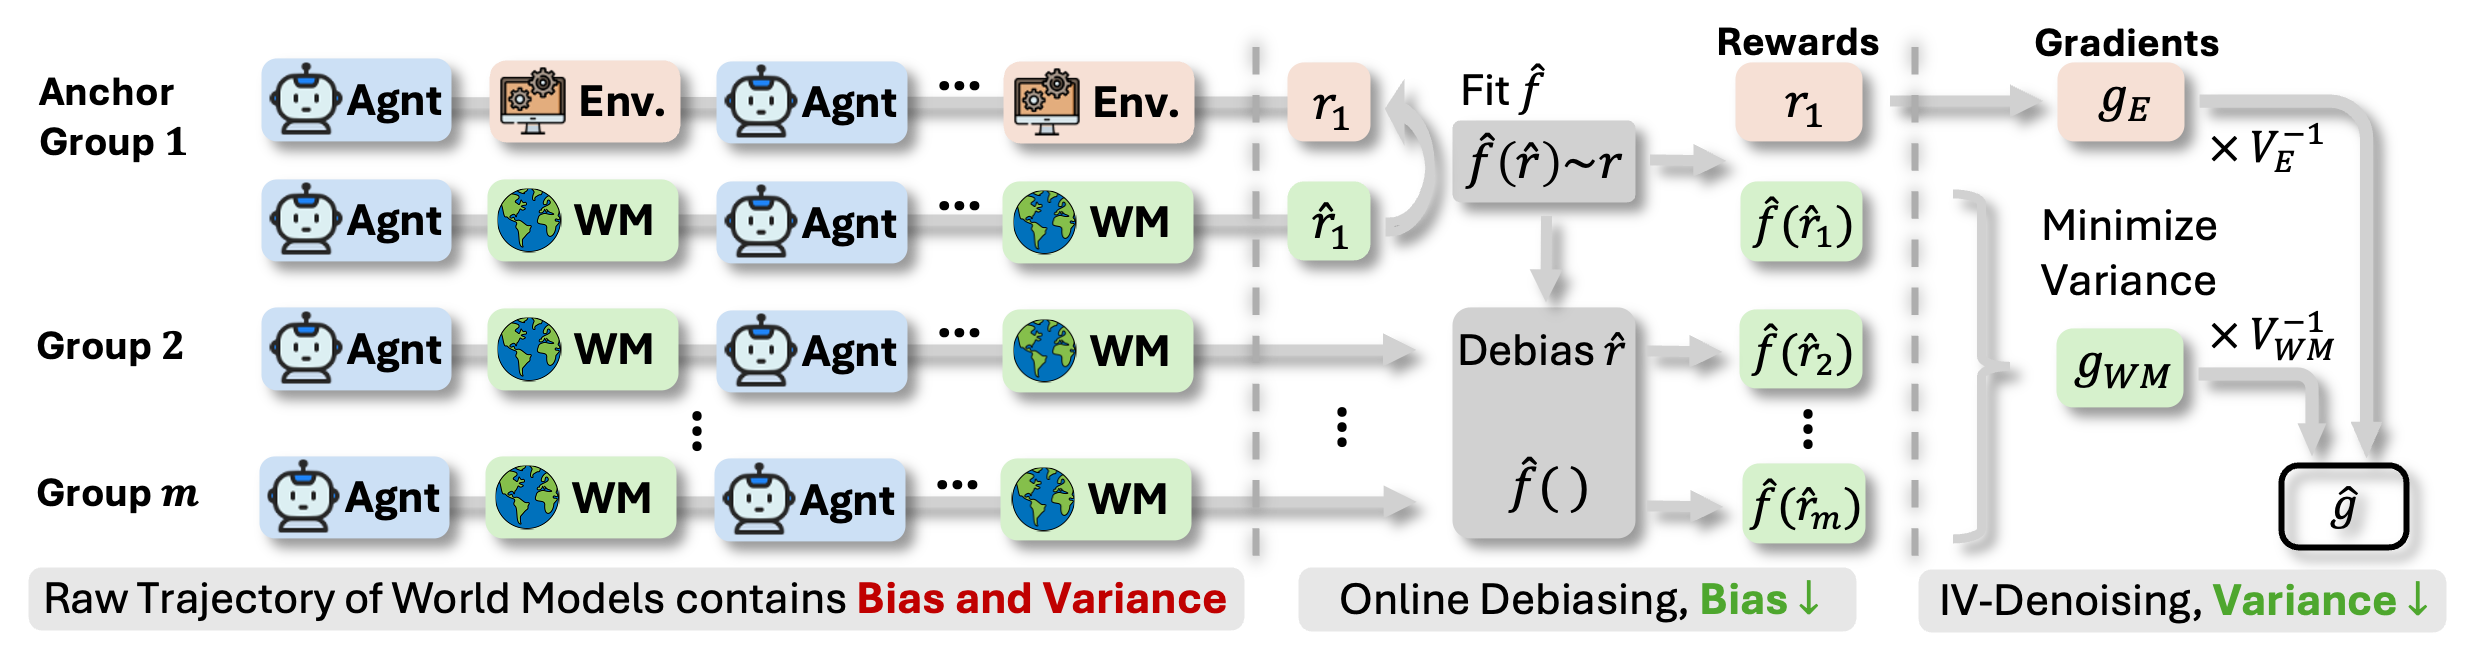
图源:作者项目页,左侧是环境与世界模型轨迹,中间校正奖励偏差,右侧降低训练信号方差。
6. StudentSim: Training LLM-based Student Simulators
中文摘要:StudentSim 训练能够模拟具体学生的 LLM。普通角色扮演模型虽然能回应教师讲解,却未必保持被模拟学生的真实水平;传统状态模型能拟合表现,又不擅长理解解释和纠正。StudentSim 先汇总训练,再基于稀疏个人数据进行专门化,让模拟器同时匹配学生行为和接受指导后的变化。
方法与结果:StudentSimEval 覆盖国际象棋、英语写作和数学中的 60 名学生,分别测行为忠实度 F 与指导响应度 R。国际象棋中,作者报告 F=0.51、R=0.91,高于所比较的 GPT-5.4;与 Maia2 相比,主要差距出现在响应教师指导的能力上。进一步将模拟器作为 tutor RL 的奖励模型,得到专家评价更好的教学 Agent。
怎么看:这篇的关键是学生模拟不能只追求“答得好”,还要答得像目标学生、在指导后改变得合理。它可以帮助筛选教学策略,但模拟器分数不是实际学习效果。60 人、三个领域的验证也不能自动覆盖不同年龄和课程,后续仍需要真实学习者实验,并关注错误模拟是否让教师策略产生偏差。
7. Omni-IO Skills: Harnessing Your Agent Omni-Native
- 点赞:451
- HF 机构:National University of Singapore
- 链接:HF · arXiv · GitHub / 项目入口(113 stars)
中文摘要:Omni-IO Skills 不重新训练一个全模态模型,而是通过即插即用 harness,把现有 Agent 扩展到文本、图像、音频、视频、文档、3D 和代码工作流。核心包括层级 skill、标准化多模态执行接口、依赖感知编排,以及用于保存和复用中间产物的 Asset Registry。
方法与结果:多资产任务被表示为 Declare Execution Graphs,独立操作可以并发,成功结果登记后供下游节点和后续对话使用。27 个 skill 覆盖七种产物模态、四类能力和 38 个代表任务。在 UniM-90 上,作者报告两个宿主模型的输入支持率从约四成提高到 100%,语义与质量联合分数、结构分数也显著提高。
怎么看:它很贴近实际的多模态 Agent 工程:难点不只是接入模型 API,而是依赖、资产、工具接口和跨轮修改能否保持一致。需要区分“可处理该输入”与“每种模态都高质量完成”。部署成本也包含外部执行后端,复现时不能只统计宿主语言模型的 token,而漏掉图像、音视频和 3D 服务。
图源:作者仓库,展示技能展开、执行图验证、按依赖调度和跨轮资产登记。
8. Atria Dawn: The Dawn of Agentic Superintelligence
中文摘要:Atria Dawn Preview 是面向科研和工程工作流的 Agentic 语言模型,使用 Verifiable Experience Pipeline,把工具交互、可执行环境和外部验证结果连接成训练经验。论文除了测任务表现,也分析模型研发过程中的人机协作,尝试说明 Agent 如何从任务执行者进入项目协作过程。
方法与结果:作者在 16 个科研、工程和数字工作 benchmark 上报告竞争力,并在其中五个取得其报告范围内的最高分。协作案例分析使用 56 名参与者的 769 条任务记录及 Agent 日志;参与者认为约三分之一已完成的 AI 辅助任务,在无 AI 时不可行。日志同时显示,Agent 经常提出方法和修改,但最终方向决策仍主要由人做出。
怎么看:标题里的“超智能”不能替代实验结论,本文更有价值的是可验证经验训练和项目级协作证据。参与者对无 AI 情况的判断属于回顾评价,不是随机对照实验;benchmark 领先也不等于科研结果天然可靠。实际使用仍要保存实验来源、人工决策和验证记录,让自动化程度与可审计性一起提高。
9. Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills
中文摘要:Repo-To-Skill 关注模型“知道一个方法”与“真正把方法跑起来”之间的操作知识差距。许多经验藏在代码仓库和论文里,既太长,也不适合任务期间全部加载。DisCo 将这些内容蒸馏成紧凑、经过验证的 skill,支持预先整理通用技能和针对当前任务临时制作技能两种方式。
方法与结果:AREX-Skill Library 从 1000 个常用 ML 仓库蒸馏出 5000 多个 skill,组织为 20 个领域、178 个能力家族。固定模型骨干、研究 harness 与下游执行预算后,作者报告相对无 skill 的同一 Agent,MLE-bench、PaperBench、FrontierCS 和 PassNet 得分分别提高 134.3%、34.4%、9.2% 和 14.0%。这些是相对提升,不是百分点。
怎么看:这里的贡献是把工程操作上下文变成可调用资源,而不是把整份 README 塞进 prompt。对 ML 研究 Agent 很有参考价值,但“经过验证”仍要问清环境、依赖和版本范围。技能库变大之后,如何检索正确 skill、避免过时调用、适应仓库升级,也会成为独立瓶颈,不应只看技能数量。
10. MaLiang-Harness: A Programmable Path to Image and Video Generation
中文摘要:MaLiang-Harness 研究用可执行程序生成图片和视频。代码能跑并不代表画面符合需求,作者把这个差距称为 Program-to-Visual(P2V)gap。框架将视觉程序、修改历史和验证绑定到同一版本,让构建、渲染、检查和修订成为持续过程,而不是运行成功就宣布结束。
方法与结果:PEG 保存程序和任务状态,TGP 把编辑关联到渲染证据,REV 支持恢复并在交付前验证当前版本。论文测了 11 个图像生成模型和四个视频生成模型,报告 GPT-6-Astra 两类任务运行成功率均为 100%,但满足所有质量阈值的比例分别是 96.0% 和 76.9%。这正好说明运行成功与视觉合格是两项指标。
怎么看:这篇适合做代码驱动图表、动画和视觉工具的开发者。复现也要注意发布范围:作者 README 明确指出完整数据集、历史生成结果和全部视觉评分流程未包含在当前仓库中,公开命令的完成率不是论文视觉质量通过率。不能仅运行脚本,就把自己的结果和论文分数直接比较。
11. Continual Learning Mechanisms Compose for Long-Horizon Memorization
中文摘要:这篇研究语言模型如何连续学习并长期保留信息。作者设置了 100 个问答任务的持续监督微调场景,不保留早期训练样本,推理时也不给任务标识。简单顺序更新会产生严重遗忘,单个持续学习机制同样难以撑过这个长度,因此论文考察互补机制的组合,而不是继续寻找一个万能方法。
方法与结果:组合沿两个维度展开:数据、函数和权重锚点规定要保留什么,低秩分配规则规定每次更新存放在哪里。作者用三个 100 任务数据集、任务级 successive halving 和因子实验测独立效应及交互效应。最佳组合包含三类锚点与 merged LoRA,平均最终保留率从朴素微调的 1.2% 提高到 34.9%,数据锚点和 merged LoRA 的交互收益尤其明显。
怎么看:28 倍相对提升很显著,但绝对保留率仍只有约三分之一,不能写成长期记忆问题已经解决。这是参数层面的持续学习,也不等同于检索式 Agent 记忆。后续可关注组合的计算开销、任务规模继续扩展后的表现,以及真实任务是否也具备相同的机制互补性。
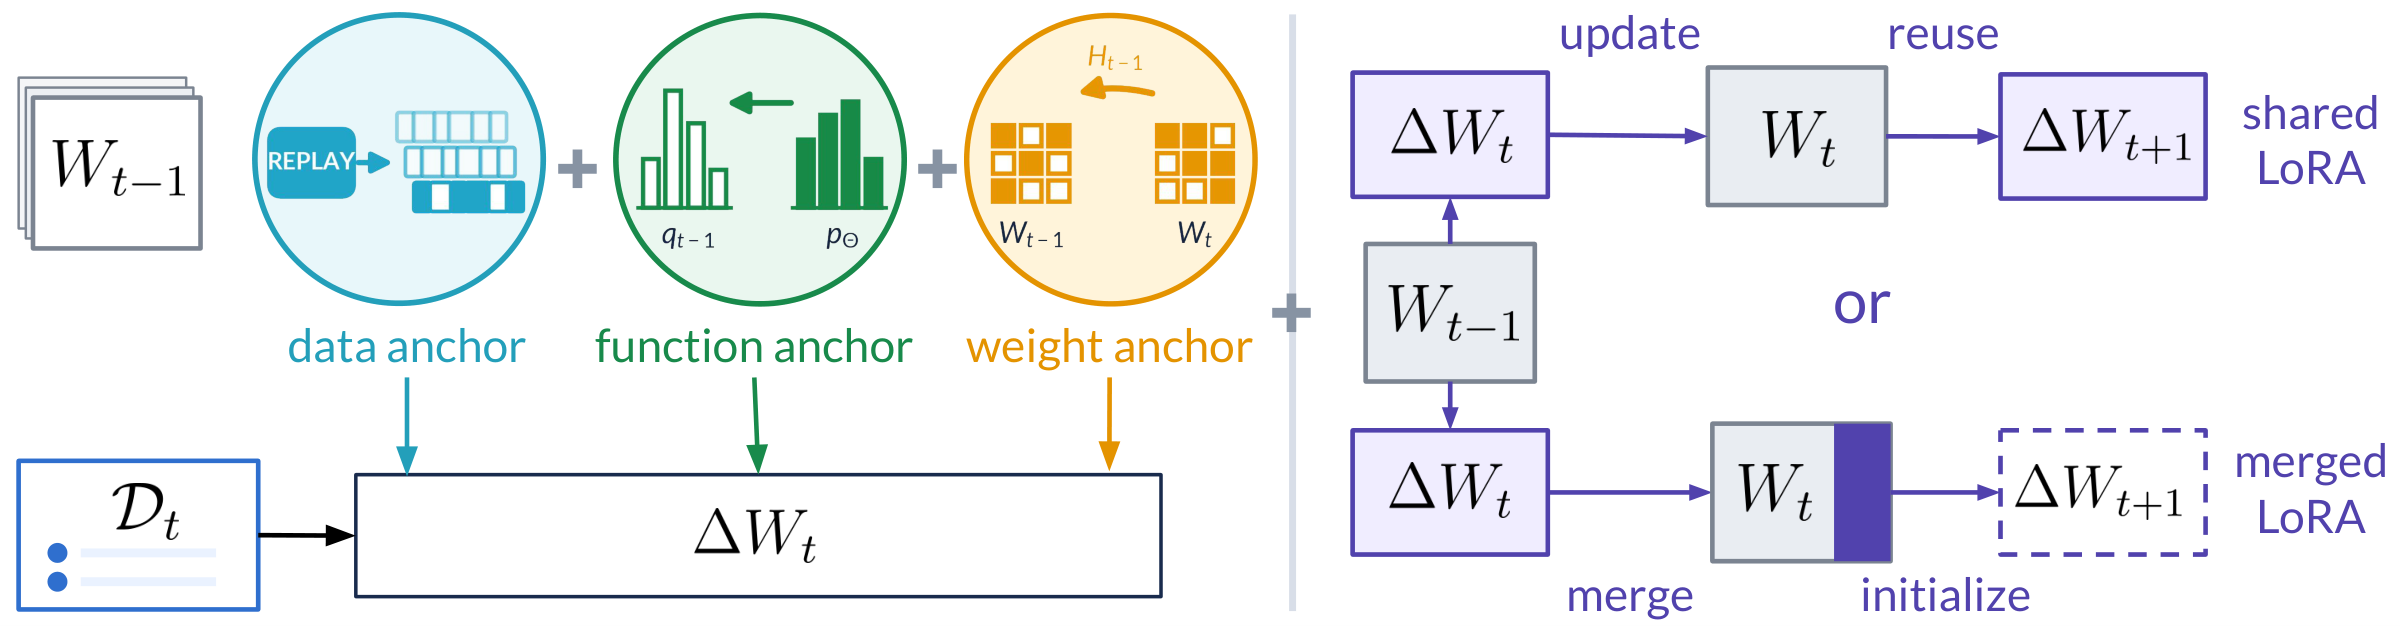
图源:作者项目页,左侧组合数据、函数、权重约束,右侧比较共享与合并 LoRA 的更新方式。
12. In-Context Learning for Robots: Methods and Applications
中文摘要:这是一篇机器人上下文学习综述,讨论部署时不更新神经网络参数,如何利用演示和交互,让机器人理解新任务并执行。它不只把 ICL 当作在 prompt 中加几个示例,而是围绕上下文证据如何连接物理动作,梳理不同接口和迁移假设。
方法与内容:综述分出四类方法:上下文条件策略、几何演示迁移、世界模型控制,以及 skill 和 Agent 驱动执行。它比较训练、对应关系和记忆的作用,并在操作与导航中考察对象、环境和执行条件变化后,机器人是否保留被教的要求。评测则区分对教学的响应、物理迁移和经验保留收益。
怎么看:这篇适合先建立领域地图,再沿具体方法深入阅读。尤其要分清“参数固定”和“无需训练”:机器人可以在部署时不更新参数,但仍依赖大量前期训练。示范跟随、换物体迁移和长期积累经验也是不同能力,不能凭一个场景成功就同时宣称三者成立;综述价值主要在分类与评价框架,而非新模型成绩。
13. Compile by Training: Turning Natural-Language Specifications into Local Neural Functions
中文摘要:许多文本函数可以用语言描述,却不好写成明确规则;每次调用远程大模型,又有重复成本、延迟和服务依赖。Compile by Training 将自然语言规格编译成可复用的本地神经函数:编译时用 teacher 生成任务样本,训练小 adapter;运行时只需要紧凑 interpreter 和该 adapter,不再依赖 teacher。
方法与结果:它延续 Program-as-Weights 路线,但通过训练换取更强的规格匹配能力。在快编译器没有得到精确匹配的 FuzzyBench-Hard 子集上,作者报告 83.6% 语义准确率,代价是编译从几秒增加到约一分钟。论文通过网站助手、语言控制 3D 角色和双向翻译器演示函数的存储、版本化与组合使用。
怎么看:它适合输入频繁、任务定义相对稳定的模糊函数,把一次编译成本摊到大量调用上。83.6% 语义准确率也意味着仍有错误,不能把神经函数当成确定性程序的无损替代。评估时要看编译样本覆盖、运行分布变化、异常输入和回退策略,而不是只比较一次推理价格。
14. Scaling Properties of Same-Family On-Policy Distillation
中文摘要:这篇系统研究同一家族模型之间的 on-policy distillation(OPD),比较弱到强、同底座以及强到弱的 teacher–student 配置。问题不只是蒸馏最终有没有提升,而是推理能力能传多少、传多快,以及 teacher 的规模和分数分别怎样影响 student。
方法与结果:作者发现早期训练存在规律性的 useful-transfer 区间,隐藏集准确率随学生偏离初始化的程度近似线性增加。所有观测到的弱到强配置中,学生峰值分数都超过了 teacher 自身。拟合的幂律显示,teacher 变大的收益在接近 student 规模时趋于饱和;同等任务分数下,较小 teacher 反而可能传递得更好。
怎么看:选 teacher 不能只按榜单得分排序,监督价值还取决于模型规模和分布结构。它为用小型 RL 专家改善大模型提供了实证依据,但结论范围是所测试的同家族配对与任务,不能直接外推到任意跨家族模型。实际应用还需比较训练阶段、峰值出现位置和过度蒸馏风险,不只是最终 checkpoint。
15. NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness
中文摘要:NeoHorse-1 将递归自我改进具体化为评估、选择和更新循环。系统先在异构模型池中记录能力需求预测、服务层级选择和交互结果,再把包含推理、工具调用及 harness 上下文的轨迹整理成训练样本,让执行经验影响下一轮后训练。
方法与结果:数据经过结构验证、六维语义评估和子场景标注,路由信号组织三阶段课程 SFT,并进一步指导 on-policy distillation。能力评估反馈再决定下一轮训练混合。作者在 11 个 Agent、工具、代码和指令 benchmark 上报告:4B 宏平均从 58.94 提高到 64.87,9B 从 65.60 提高到 69.04,缩小了小模型与较大底座的差距。
怎么看:值得学习的是数据路由与评估如何进入训练闭环,而不是把 RSI 当作标签。论文将其描述为初步原型,一轮后训练成功不能证明无限轮次都会提升。继续迭代时,需防止能力评价误差放大、训练分布变窄和旧能力遗忘,并保留独立隐藏集来检查更新是否真正泛化。
16. Qwen-Drive-1.0: An Initial Step towards a Vision-Language Foundation Model for Autonomous Driving
中文摘要:Qwen-Drive-1.0 保留预训练 VLM 架构,在共享表示上统一三维感知、视觉问答和运动规划。外部 BEV 感知头负责 3D 检测、语义占用预测和地图分割,Planning Expert 则利用共享 VLM 表示生成未来自车轨迹。
方法与结果:BEV 头不仅是任务模块,也作为共享表示中三维信息的可检查接口。分阶段训练结合驾驶监督和通用视觉语言数据,在获取驾驶能力的同时,尽量保持视觉理解和指令跟随能力。作者报告三维感知与驾驶场景理解表现,并在开环、伪闭环和闭环条件下比较轨迹规划,摘要没有提供可直接汇总的统一数值。
怎么看:它的重点是通用 VLM 与专业感知、规划模块能否共享底座,而不是完全替代所有驾驶系统。三类评测设置不能混用:开环预测好,不等于实际反馈控制也安全。要进一步核对长尾交通事件、传感器退化、实时延迟和分布外环境;实验竞争力不能当成道路部署安全的证明。
17. Dr. Claw: An AI Scientist Workspace for Vibe Research
- 点赞:285
- HF 机构:页面未给出,需从论文或作者资料核验
- 链接:HF · arXiv · GitHub / 项目入口(1155 stars)
中文摘要:Dr. Claw 不另造一个完全自主科研 Agent,而是给现有命令行 coding Agent 增加人机协作工作区。研究过程常分散在聊天、IDE、终端和写作工具中,关键决策也没有被保留下来。它利用持久状态对象、skill library 和多执行器协调,把规划、实验与写作接到一条可追溯、可恢复的工作流上。
方法与结果:论文展示交互式三视图和失败恢复过程,并固定底层执行器,与裸命令行 Agent 比较。工作区在研究完整性上取得更高分,同时保存过程轨迹。需要注意,该比较考察的是任务图、状态对象和技能库组成的完整编排层,不能把收益归因于某个单独组件,也不能解释成底层模型本身更强。
怎么看:它对需要人工持续介入的科研自动化很实用:人保留方向判断,Agent 负责执行,失败后还能恢复上下文。论文摘要说明项目采用 AGPL-3.0 并包含 GPL-3.0 上游组件,集成时应核对仓库许可说明。更重要的是检验证据是否真的落盘,而不是界面看起来有阶段进度就认为过程可审计。
18. Post-Training Leaves Behavioral Shadows on Unrelated Decisions
中文摘要:这篇研究后训练能力是否会在与目标任务无关的输出中留下可学习信号。Active Taskless Distillation(ATD)只向 teacher 每次取一个普通单词:选择共享公开祖先模型几乎无法区分两个候选词的提示,用 teacher 的选择构造训练对,再让同祖先初始化的 student 学习。学生不接触目标任务样例、teacher logits 或参数。
方法与结果:作者公开仓库的主要代码实验使用每组 5664 条记录、四个配对训练种子和 164 个 HumanEval+ 任务。信号组 pass@1 为 51.22%,精确匹配对照为 45.88%,差值 5.34 个百分点,95% 置信区间为 1.22–9.60 个百分点。训练数据是完整“提示—单词”配对,不是只凭一个孤立单词恢复能力。
怎么看:它提示任务无关生成也可能携带后训练后的行为差异,蒸馏研究不应只盯着显式答案。但结论依赖提示选择、共同祖先和严格对照,不能写成从任意模型随便取词就能复制技能。公开代码可重算冻结实验,原始私有 teacher 的重新生成则不在发布范围内;统计复现与重新训练应分开看。
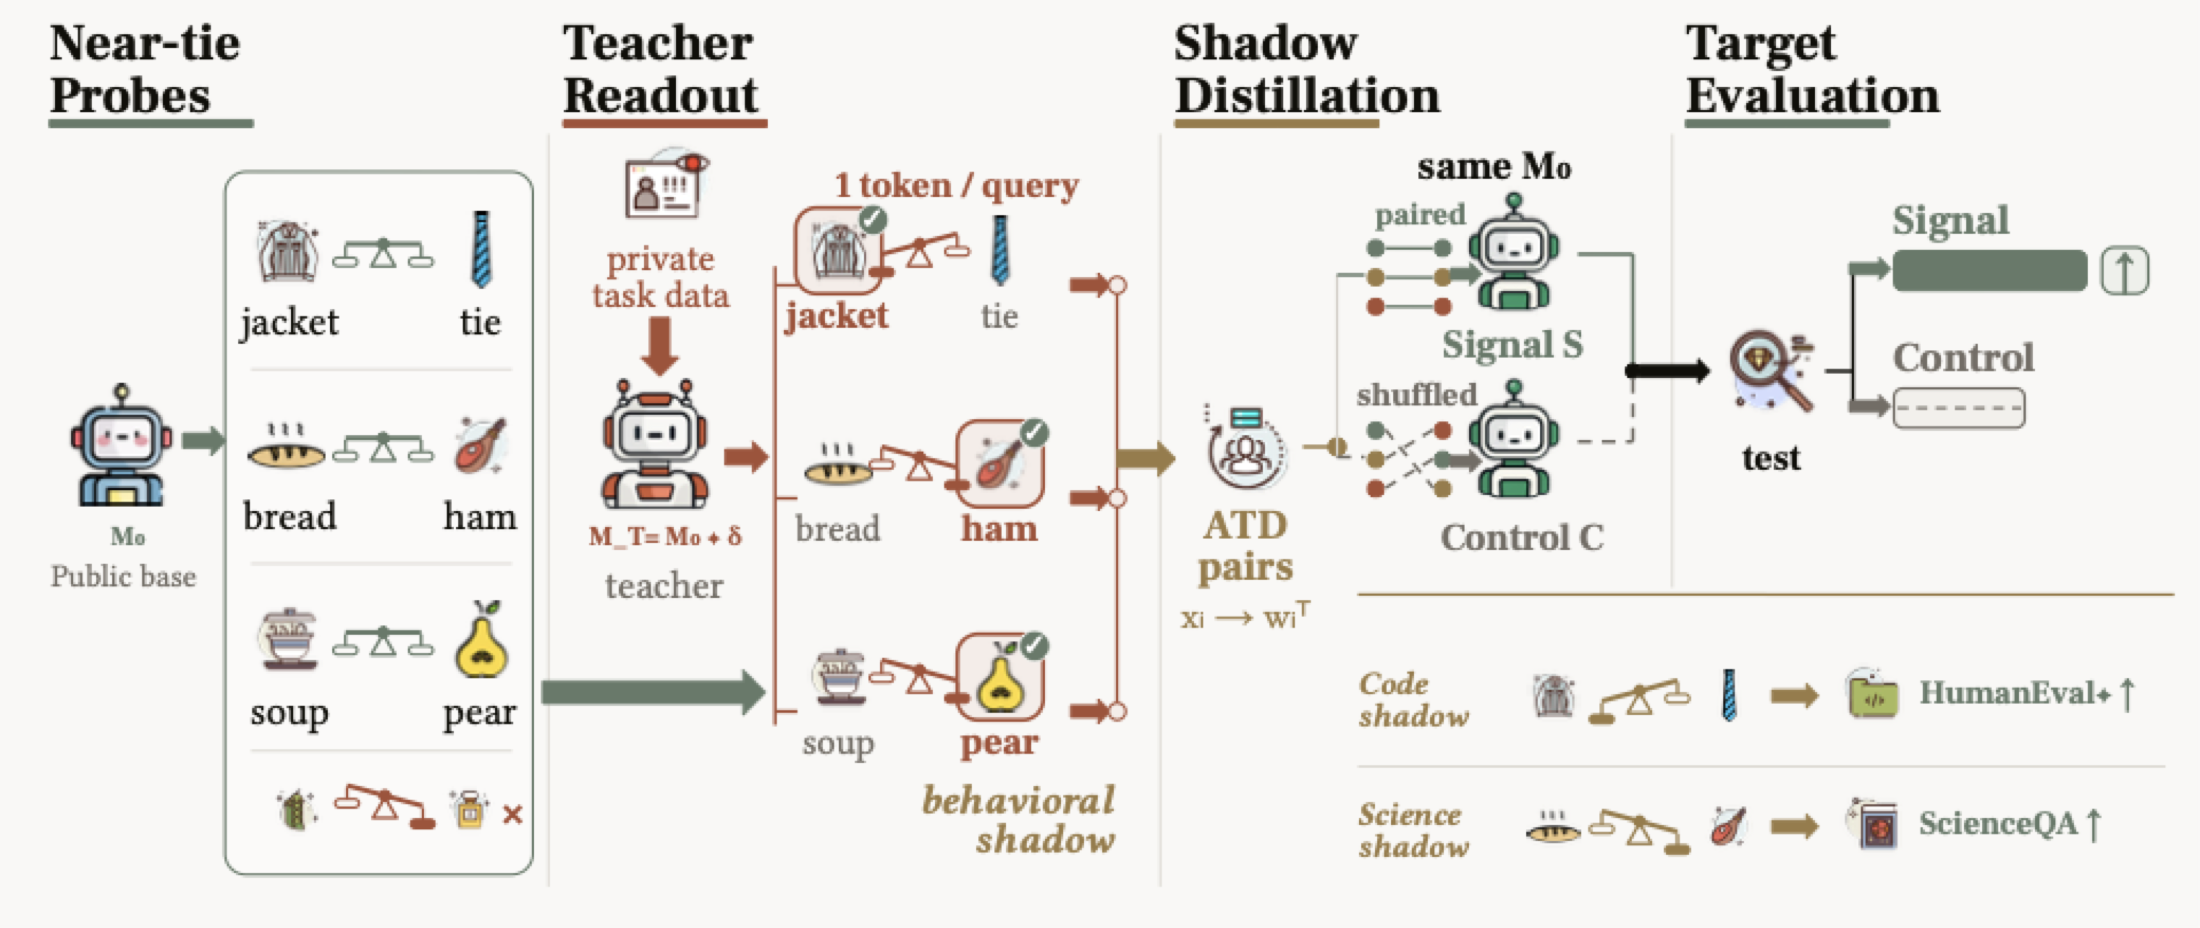
图源:作者仓库,展示接近平局的提示、teacher 单词选择、信号与对照训练,以及目标任务评估。
19. Aspire: Can Models Self-Evolve from Vague Goals?
中文摘要:ASPIRE 给 Agent 的不是明确任务和固定奖励,而是类似“提高科研能力”的模糊目标。模型需要自行解释目标、寻找能力缺口、选择数据与更新方式、构造训练和验证信号,并判断是否真的进步。框架同时支持模型权重演化与 harness 演化,下游评测对开发过程隐藏。
方法与结果:隐藏集由专家编写,覆盖六个目标、520 个项目。作者发现当前 Agent 通常能完成训练或框架修改循环,但权重层面的提升稀少且不稳定,最强演化 harness 也仍落后于所比较的人工 Qwen-Agent 框架。常见问题是数据与目标不匹配、相信狭窄自评,以及继续训练反而抹掉先前收益。
怎么看:它和 HarnessDev 是很好的配套阅读:一个看能否开发执行框架,一个看能否从模糊目标决定学什么。完成训练流程不是进步,局部验证变好也不是隐藏能力变好。对自我改进系统,明确停止条件、保存已验证版本和使用独立评价,比单纯让 Agent 多循环几轮更重要。
20. NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
中文摘要:NCP-ArchPreview 在标准 Next-Token Prediction(NTP)之外,加入 Next Concept Prediction(NCP)。模型从隐藏状态构造乘积量化的离散概念词表,Concept Module 预测跨多个 token 的未来概念,再把概念反馈给 token 层,保留普通自回归生成接口,同时增加更高层的学习目标。
方法与结果:作者将架构扩展到 8.9B 参数,在 Dolma-3 上训练 5.73T tokens。其报告称,使用 51.3% 的训练 token 时已达到 OLMo-3-7B 的最终预训练损失,完整训练后下游宏平均高 2.45 分、GSM8K 高 5.99 分。参数严格对齐的 8.9B 对照中,使用 85% 标准计算量即可接近其损失;17M 参数量化模块也可用于轻量领域适配。
怎么看:关键不是给 token 换名字,而是让概念预测成为独立训练目标,并与生成表示交互。51.3% token 不能直接换算成总训练成本减半,因为模型规模和架构不同。公开评测仓库还区分常规目标模型与实验性推测解码路径,复现时应固定模型版本、数据和评分协议,再比较效率与质量。
小结
这个月最值得一起读的是三组:Raven、HarnessDev 和 ASPIRE,分别谈能力组合、框架自开发和模糊目标驱动演化;Omni-IO、Repo-To-Skill 和 Dr. Claw,分别谈多模态资产、操作知识和科研流程;OPD Scaling、ATD 和 NCP,则从监督迁移、行为信号和概念空间探索模型改进。把这些论文放在一起看,更容易区分“系统能跑起来”“任务表现提高”和“跨任务可靠泛化”三个不同层次。
本文是基于原始摘要与作者项目资料的月度介绍,不替代完整实验复现;图片均使用作者公开站点或仓库的原图外链,无需另行上传。